Escolas poderão usar a Busca do Google sem aceitar IA?
Escolas poderão desativar o Gemini e manter a Busca, mas os recursos de IA da pesquisa continuam. Entenda o anúncio e as dúvidas sobre o Brasil.

Escolas poderão desativar o Gemini e manter a Busca, mas os recursos de IA da pesquisa continuam. Entenda o anúncio e as dúvidas sobre o Brasil.
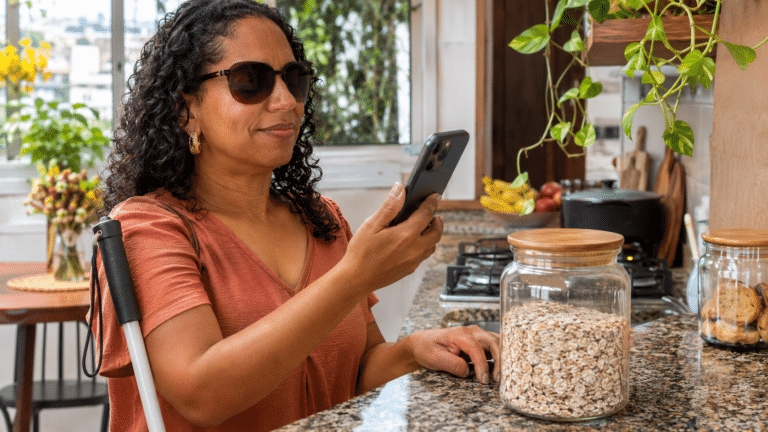
Recurso do Gemini Live usa a câmera do celular e inteligência artificial para oferecer descrições em áudio e orientar o enquadramento. Entenda como funciona e quais são seus limites.
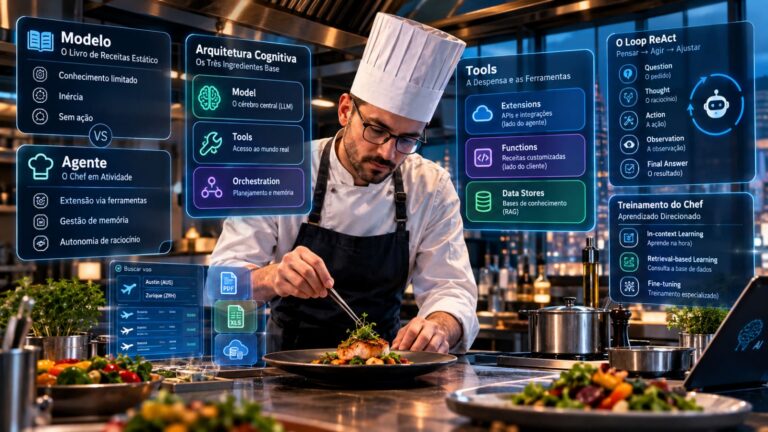
Conheça os fundamentos da orquestração de agentes de IA através da metáfora da cozinha profissional. Entenda as diferenças entre modelos de linguagem e agentes, os pilares da arquitetura cognitiva e diferentes formas de aprendizado.
A fusão entre xAI e SpaceX criou a SpaceXAI, unindo foguetes reutilizáveis e modelos de linguagem de fronteira. Enquanto algoritmos como o ASTERIS triplicam a detecção de galáxias primordiais no James Webb, a Starship aproxima-se do voo orbital e a NASA reavalia prazos para o retorno à Lua.
Benchmarks de contexto longo, modelos de raciocínio, Process Mining e arquiteturas multi-modelo mostram que o próximo salto da IA empresarial depende menos de potência bruta e mais da capacidade de transformar inteligência computacional em processos melhores.
Para obter melhores resultados do DeepSeek, especialmente dos modelos de raciocínio como o DeepSeek-R1, adote estas técnicas avançadas de engenharia de prompts.

A Inteligência Artificial está deixando de ser promessa para se tornar uma ferramenta essencial na inclusão de pessoas com deficiência. Conheça os avanços de 2025 que estão revolucionando a tecnologia assistiva, de assistentes personalizados a dispositivos que leem o mundo.
DeepSeek-R1-Distill-Llama-70B é um modelo destilado com 70 bilhões de parâmetros, baseado em Llama-3.3-70B-Instruct. Otimizado para raciocínio matemático e lógico, apresenta alto desempenho em benchmarks (AIME, MATH-500, CodeForces). Com janela de contexto de 128 K tokens e geração a 275 tps, é indicado para ensino, programação e análise estratégica, usando temperatura 0,6.
Modelo leve e eficiente baseado na arquitetura da Meta, o Llama 3.1 8B no Groq é projetado para respostas rápidas e de alta qualidade. Com suporte a chamadas de função, modo JSON e uma janela de contexto de 128K tokens, ele se destaca em aplicações em tempo real — combinando desempenho robusto com baixo custo operacional.